
전체 파이프라인에 대한 부분은 아래 글을 참고.
https://daeunworld.xyz/aisw_maestro/2026/09/23/parrot-mimicry-pipeline-status.html
이 글의 수치는 2026-09-28 라벨 스냅샷 기준이다. 앵무 발화(mimic) 라벨 재검토는 아직 반영하지 않은 잠정 수치다.
0. 용어 정리
| 용어 | 의미 |
|---|---|
| mimic | 앵무새가 사람 단어를 흉내 낸 발화 클립 |
| non_speech(비발화) | 짹짹 소리처럼 발화가 아닌 앵무새 소리 |
| 보호자 기준음성(reference) | 보호자가 단어를 가르치기 위해 등록한 사람 음성 |
| 공용 기준음성 | 여러 계정의 보호자 기준음성을 모아 만든 단어별 대표 음성 |
| metric learning | 같은 단어 쌍은 가깝게, 다른 쌍은 멀게 임베딩 공간을 학습하는 방법 |
| projection | 동결된 인코더 임베딩을 새 공간으로 변환하는 작은 학습 레이어 |
| AUC | 성공 쌍에 실패 쌍보다 높은 점수를 주는 순위 성능. 0.5가 무작위 수준 |
| 검출률(recall) | 실제 성공을 성공으로 판정한 비율 |
| FAR | 실패(오답 단어, 비발화)를 성공으로 잘못 판정한 비율 |
1. 목표
보호자 기준음성(사람)과 앵무 발화(mimic)가 같은 단어인지 가려내는 유사도 공간을 학습한다.
두 소리는 서로 다른 종의 소리이므로, 같은 단어라면 종이 달라도 점수가 높게 나와야 한다. 종을 가로지르는 비교라는 점에서 cross-species라는 이름을 붙였다.
2. 방법론 설명
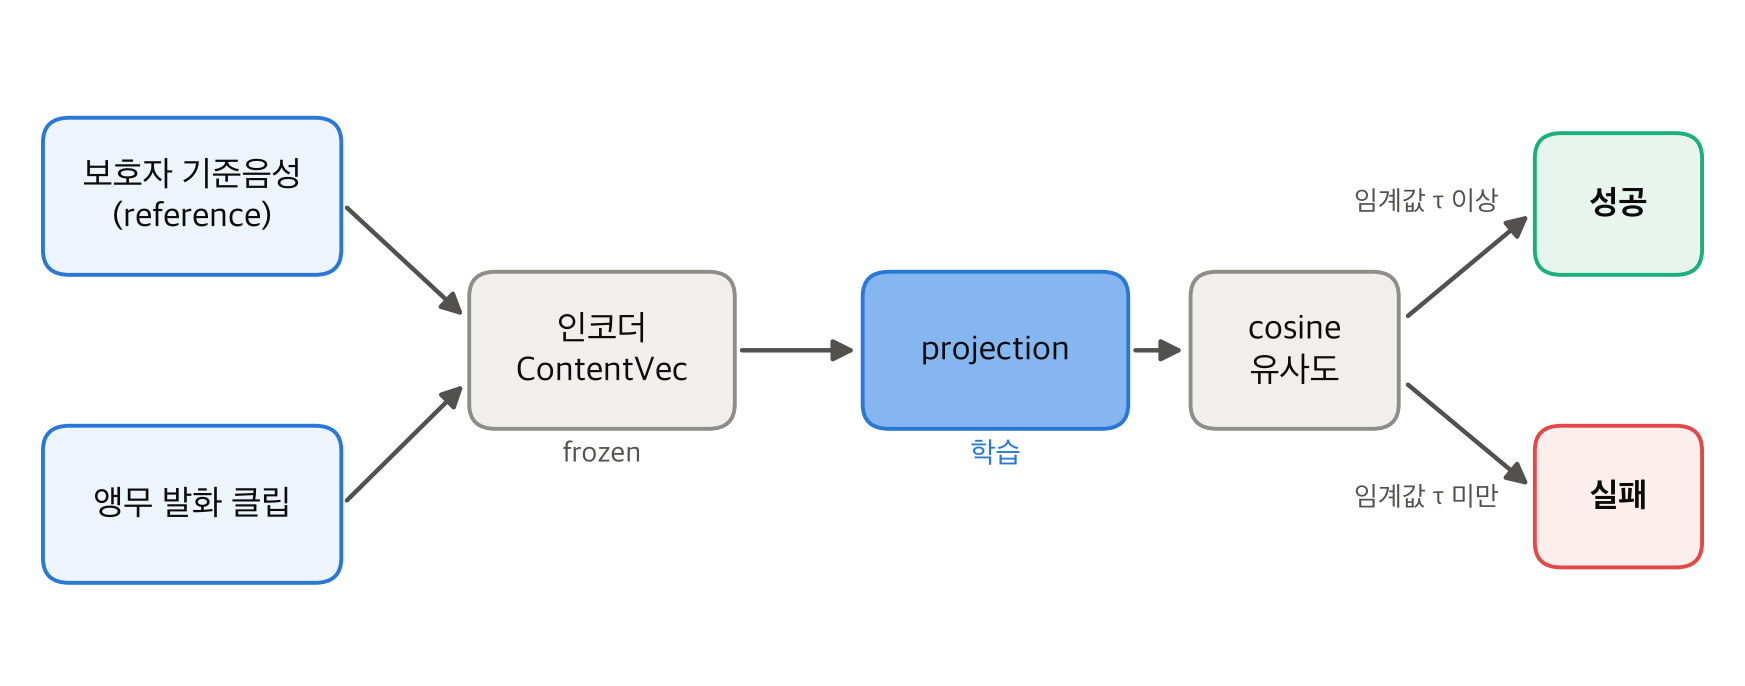
인코더는 그대로 두고, projection만 학습한다. 두 입력의 cosine 유사도가 임계값 τ 이상이면 성공으로 판정한다.
인코더는 frozen 그대로 사용한다. 인코더가 만든 임베딩을 projection이 새 공간으로 변환하고, 그 공간에서 보호자 기준음성과 앵무 발화의 cosine 유사도를 계산한다. 학습 대상은 projection 하나다.
학습 신호는 세 가지 음성으로 구성한다.
- 보호자 기준음성을 anchor
- 같은 단어의 앵무 발화를 positive
- 다른 단어의 앵무 발화와 비발화를 negative
loss는 softplus((negative 유사도 - positive 유사도) / temperature)를 최소화한다. 같은 단어는 점수가 높고 다른 소리는 점수가 낮도록 순위를 직접 학습하는 방식이다.
3. 시도한 인코더
| 인코더 | 학습 배경 | 특성 |
|---|---|---|
| Perch 2.0 | 새 소리 등 생물음향 | 종과 개체의 음색에 민감 |
| HuBERT | 사람 음성 SSL | 화자(음색) 정보를 많이 보존 |
| ContentVec (채택) | 사람 음성 SSL | HuBERT 계열에서 화자 정보를 제거하도록 학습 |
세 인코더의 기본 성능 비교는 이전 글에서 다뤘다. 그 글의 계정 내 분리도 비교에서는 ContentVec만 Perch와 HuBERT보다 높았고, HuBERT는 이 근거로 학습 후보에서 제외했다.
4. 데이터셋
| 클래스 | 클립 수 | 비고 |
|---|---|---|
| mimic | 1,123 | 소형조, 중형조만 포함 |
| 비발화 | 5,336 | negative 전용 |
| 보호자 기준음성 | 302 | 전부 사람 음성. 검수에서 기각된 148개 제외 |
평가 단어는 귀여워, 까꿍, 사랑해, 안녕, 안녕하세요, 쪽, 코코야 7개이다.
- 안녕이 mimic의 약 74%를 차지할 만큼 편중이 심해, 모든 지표는 단어별로 계산한 뒤 동일 가중 평균(macro)한다.
- 분할은 계정(UID) 단위 5-fold이다. 같은 계정의 기준음성, mimic, 비발화가 전부 같은 fold에 배정되므로, train에 포함된 계정은 test에 사용되지 않는다.
- fold는 계정별 mimic 수가 고르도록 배정하되, 기준음성을 가진 계정이 5개 이하인 단어(귀여워, 까꿍, 안녕하세요, 코코야)는 그 계정들을 서로 다른 fold에 배치했다. 이 계정들이 한 fold에 몰리면, 그 fold를 평가할 때 공용 기준음성을 만들 수 없는 단어가 생기기 때문이다.
- 결과 수치는 fold 배정에 민감하다. 이 제약 없이 mimic 수만으로 배정하면 6-1의 대표 AUC는 0.898이 아니라 0.793이다.
5. 후보 탐색 라운드
projection 형태, 입력 특징, 여러 모델의 점수를 합치는 방식 같은 후보를 라운드 단위로 조금씩 늘려 가며 고르는 방식을 사용했다,
<한 라운드의 진행 순서>
- 새 후보 설정을 한 묶음 정한다.
- 최종 평가용 fold를 제외한, 나머지 데이터로 내부 검증을 하고, 후보별 AUC를 비교한다.
- 결과를 검토해 다음 라운드에서 시험할 후보를 정한다.
지금까지의 최고 내부 AUC가 2회 연속 0.002 미만으로 증가하면 탐색을 멈추는 조건을 사용했다. 후보 목록은 9/18 데이터에서 7라운드에 이 조건에 도달할 때까지 탐색해 정했다. 9/28 데이터에서는 같은 후보로 평가와 선택만 다시 했다. 이 데이터에서는 6라운드에서 조건에 도달했지만, 7라운드 후보까지 포함해 선택했다.
| 라운드 | 추가한 후보 |
|---|---|
| 1 | 순위 학습 첫 적용. Perch, ContentVec 레이어별 projection |
| 2 | 사람·앵무 별도 projection, 학습량·temperature 조정, 인코더 특징 이어붙이기 |
| 3 | seed 5개 앙상블, 여러 모델의 점수 결합 |
| 4 | 클립을 세 구간으로 나눈 시간 구간 특징, 질의별 점수 중심화 |
| 5–6 | 시간 구간 비중과 중심화 강도 세부 조정 |
| 7 | 결합할 모델 조합 변경 |
질의별 점수 중심화는 한 앵무 발화에 대해 여러 단어 기준음성과 비교한 점수의 평균을 빼서, 발화마다 다른 점수 수준을 맞추는 보정이다.
6. 테스트 결과
6-1. 단어 일치 AUC
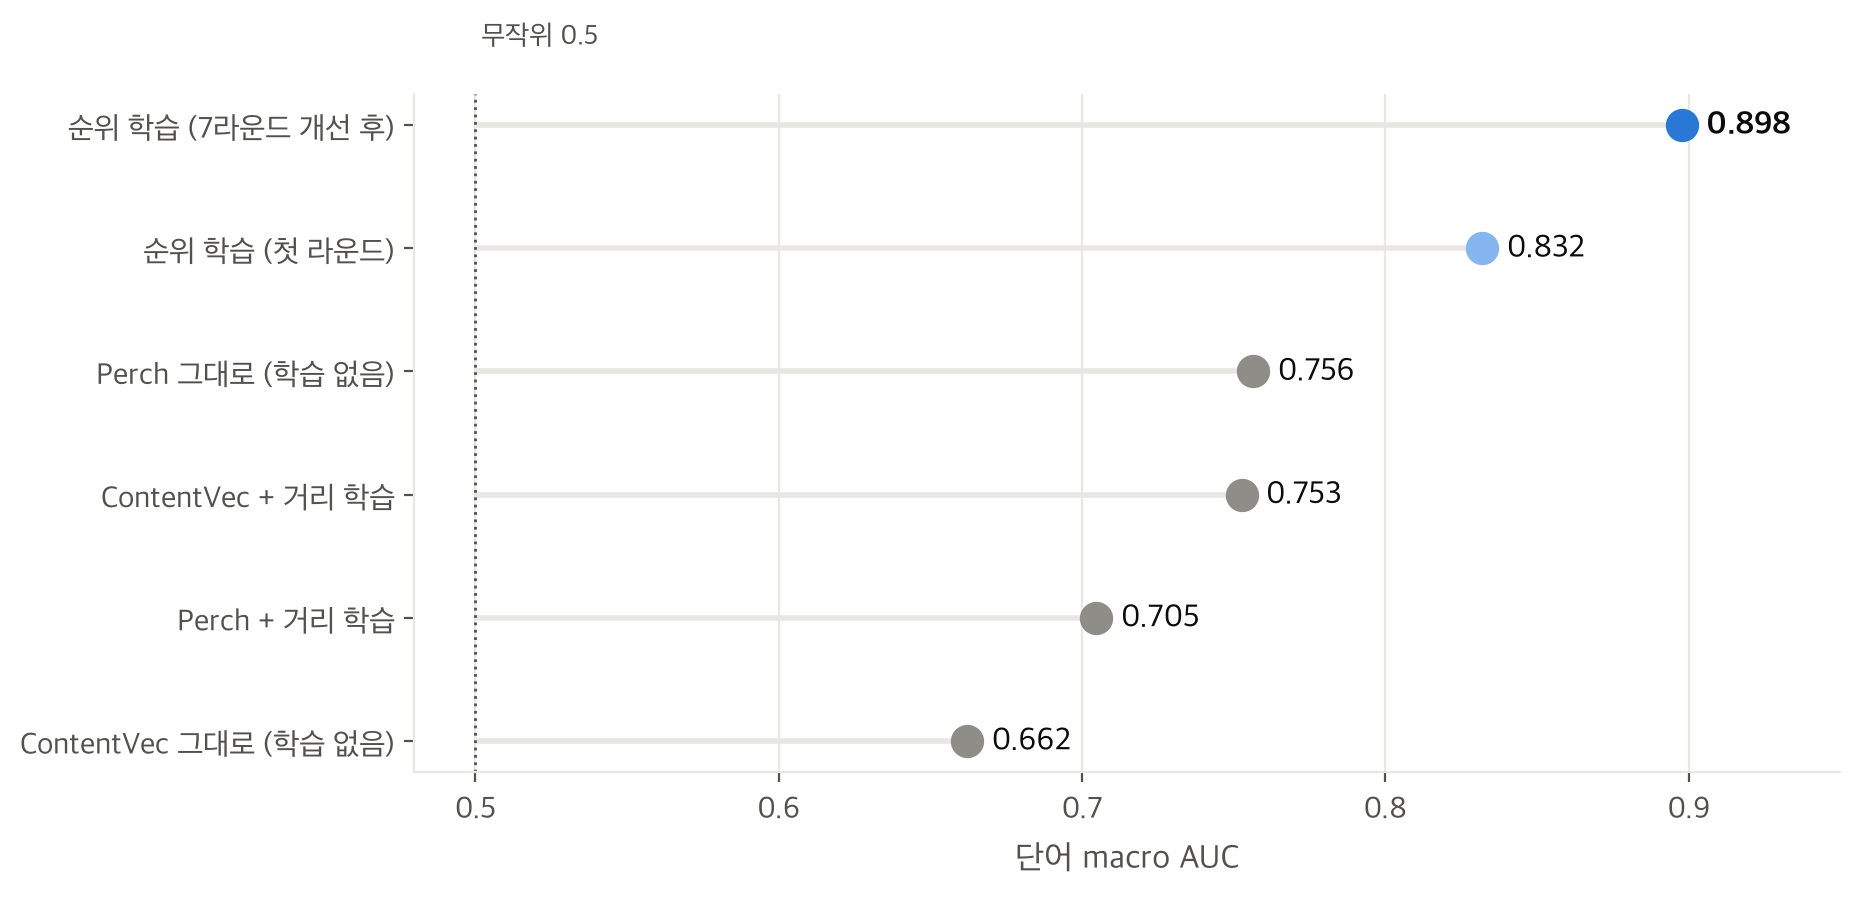 단어별 AUC의 평균(macro AUC). 회색은 비교군이고, 파란색은 순위 학습 모델이다.
학습 없이 인코더 임베딩을 그대로 비교하면 Perch가 0.757, ContentVec L9(9번째 레이어)가 0.662다.
projection을 학습하는 방식은 두 가지를 비교했다.
- 거리 학습(triplet loss): 이전 실험에서 쓴 방식. 같은 단어 쌍은 가깝게, 다른 단어 쌍은 멀게 배치하도록 학습한다.
- 순위 학습(ranking loss): 이번 실험의 방식. 같은 단어의 점수가 다른 소리의 점수보다 높도록 학습한다.
거리 학습은 두 인코더 모두 학습하지 않은 Perch를 넘지 못했다(Perch 0.705, ContentVec 0.753). 반면 순위 학습은 첫 라운드에서 0.832, 7라운드까지 후보를 늘린 뒤에는 0.898로, 학습하지 않은 Perch보다 0.141 높았다.
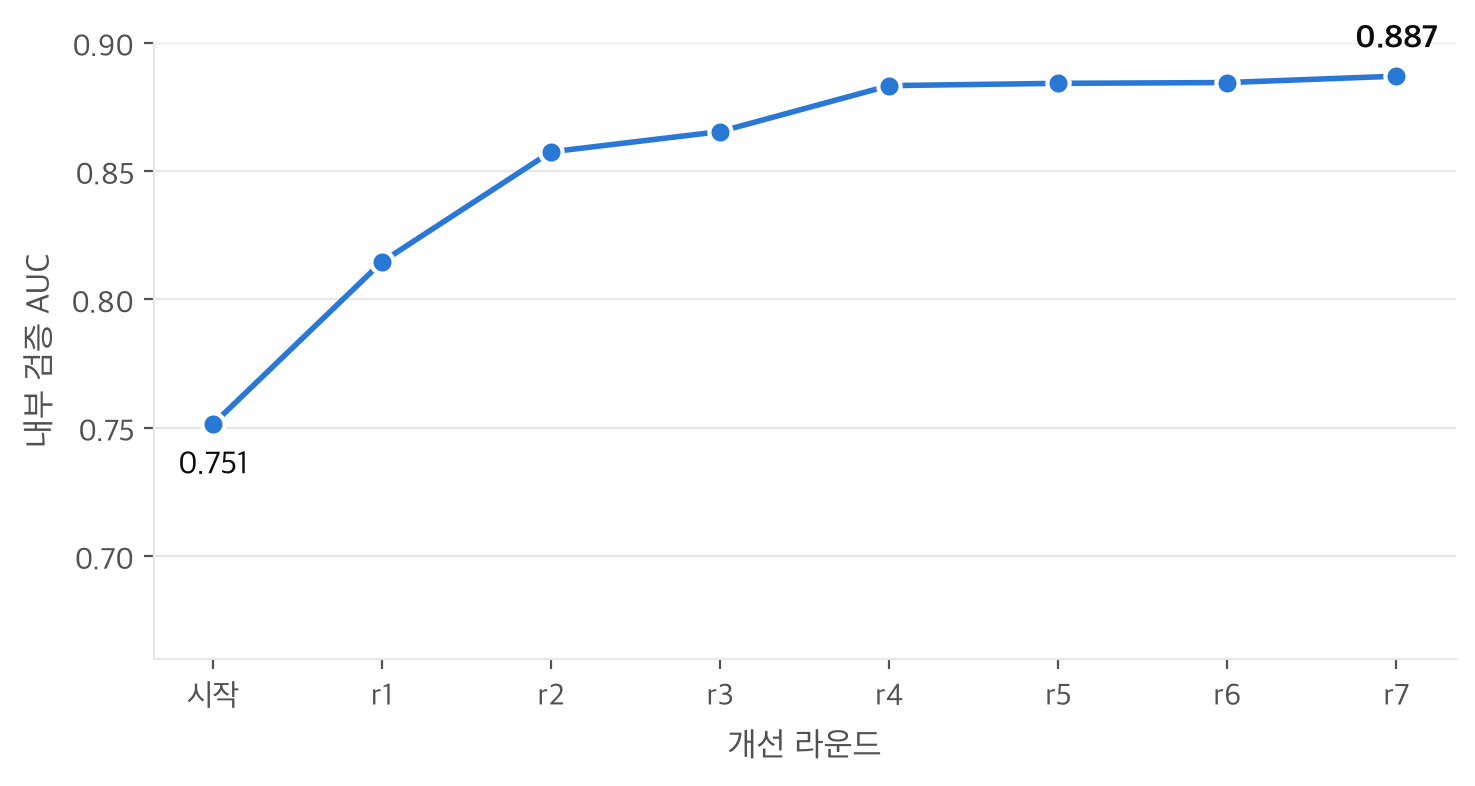 7개 라운드 동안 내부 검증 AUC 추이. 이 데이터에서는 6라운드에서 개선 폭이 2회 연속 0.002 미만이 되었다.
라운드별로 추가한 요소는 5장의 표와 같다.
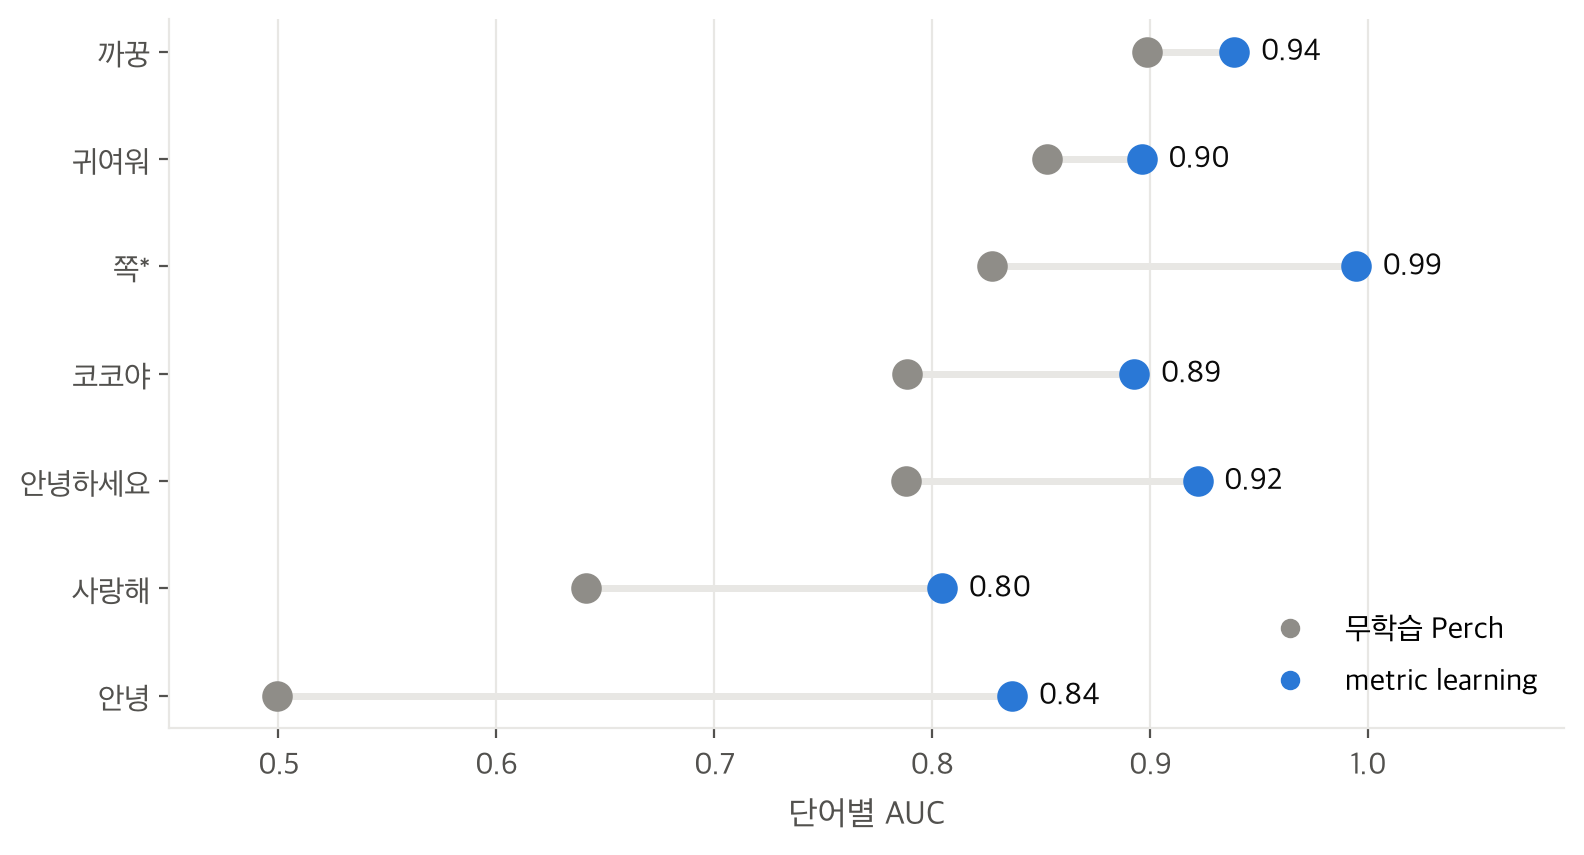
단어별 AUC. 별표를 붙인 쪽은 평가 양성이 1개뿐이라 참고용이다. 7개 단어 모두 학습 후 AUC가 올랐다.
6-2. 임계값 기반 성공 판정
AUC는 positive, negative 점수의 분리도만 평가한다.
실제 서비스는 점수가 임계값 τ 이상이면 성공, 미만이면 실패로 판정하므로, τ를 정한 뒤의 판정 성능을 따로 확인했다.
평가 방법
- training에 쓰지 않은 계정(calibration fold)에서 τ를 정한다. 오답 FAR와 비발화 FAR가 각각 목표 FAR 이하가 되는 가장 낮은 값을 τ로 쓴다.
- 정한 임계값τ를 training과 calibration 어디에도 사용되지 않은 계정에 적용해 판정 성능을 측정한다.
- calibration에 쓸 계정 fold를 바꿔 가며 20개 조합으로 반복한다.
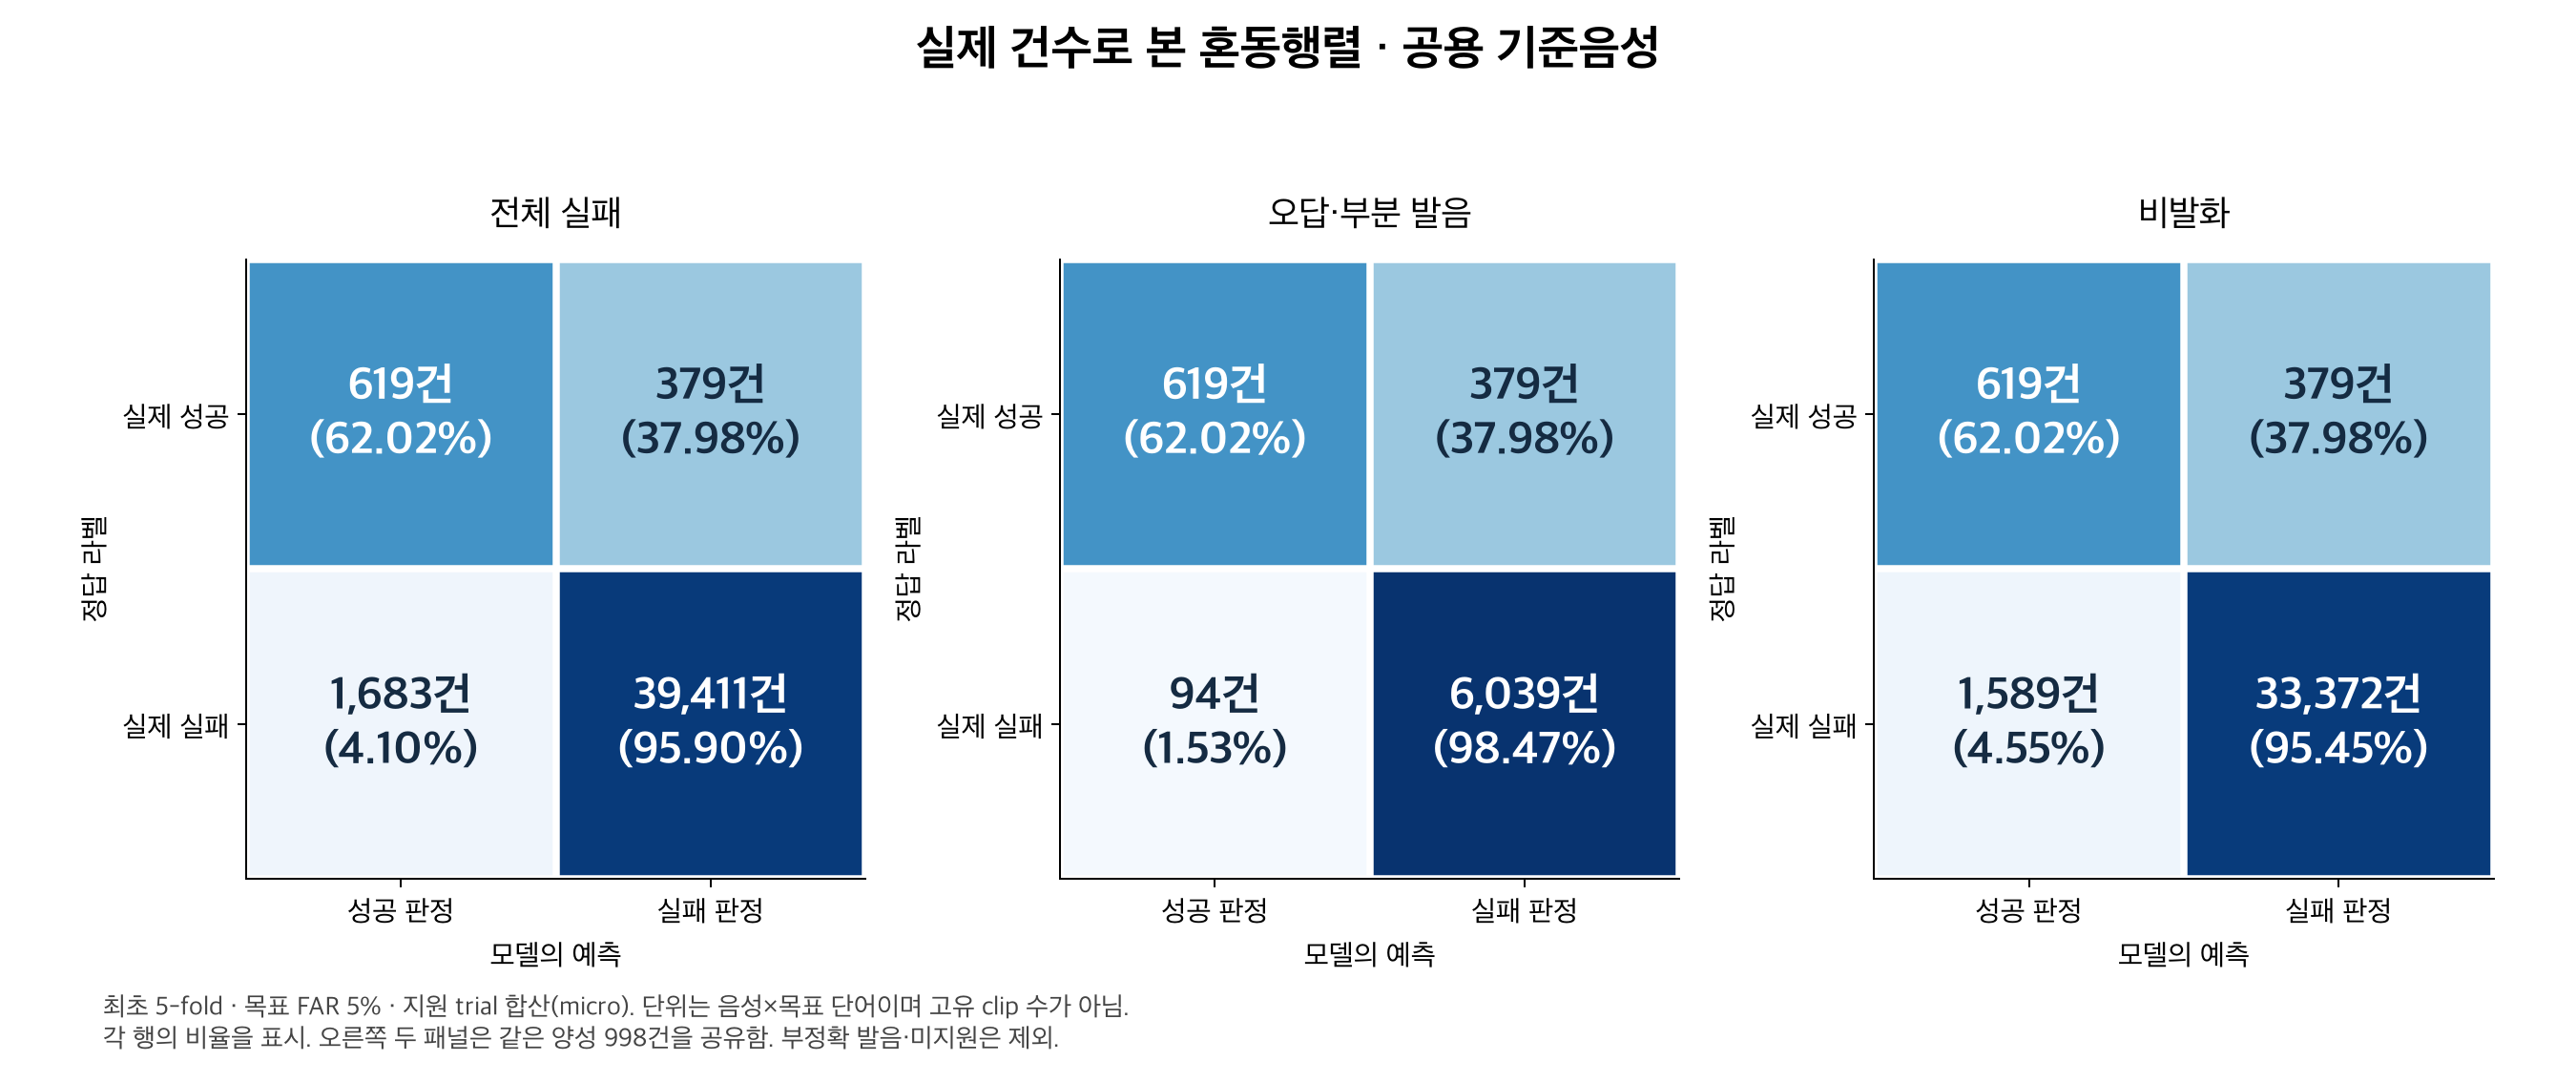
목표 FAR 5%, 공용 기준음성 조건의 실제 판정 건수.
세 혼동행렬은 같은 판정 결과를 실패 종류별로 나눈 것이다.
- 전체 실패: 아래 두 실패의 합계
- 오답과 부분 발음: 앵무가 소리는 냈지만 목표 단어가 아닌 경우
- 오답: 목표와 다른 단어를 말한 경우
- 부분 발음: 목표 단어의 일부만 발음한 경우
- 비발화: 발화가 아닌 앵무새 소리를 목표 단어와 비교한 경우
임계값 정책 비교
τ를 정하는 방식은 세 가지를 비교했다.
- 공통 임계값: 모든 단어에 같은 τ를 쓴다.
- 단어별 50% 혼합: 단어마다 따로 정한 τ와 공통 τ를 반씩 섞어 쓴다.
- 보수적 설정: calibration의 목표 FAR를 절반(5% → 2.5%)으로 낮춰 τ를 더 엄격하게 정한다.
목표 FAR 5%의 결과는 다음과 같다.
| 임계값 정책 | 성공 검출률 | 오답 FAR | 비발화 FAR |
|---|---|---|---|
| 공통 임계값 | 29.84% | 3.89% | 4.15% |
| 단어별 50% 혼합 | 48.49% | 3.40% | 3.60% |
| 공통 임계값 + 보수적 설정 | 25.25% | 2.10% | 1.89% |
표의 검출률(29.84%)이 혼동행렬(62.02%)보다 낮은 것은, 표는 단어별 검출률을 같은 무게로 평균하고 혼동행렬은 표본이 가장 많은 안녕 위주로 합산되기 때문이다.
단어마다 점수 분포가 다르기 때문에, 공통 임계값 하나를 모든 단어에 적용하면 검출률 손실이 크다.
(단어별 50% 혼합은 평균 FAR를 목표 안으로 유지하면서 검출률을 29.84% → 48.49%로 높였다.)
20개 조합 전체로 넓히면 결과는 다음과 같다(목표 FAR 5%).
| 임계값 정책 | 성공 검출률 | 오답 FAR | 비발화 FAR | FAR 목표를 넘은 조합 |
|---|---|---|---|---|
| 단어별 50% 혼합 | 39.84% | 3.11% | 3.98% | 오답 1개, 비발화 6개 / 20개 |
| 단어별 50% 혼합 + 보수적 설정 | 27.77% | 1.34% | 1.79% | 비발화 1개 / 20개 |
보수적 설정을 더하면 검출률은 낮아지지만, 20개 중 19개 조합에서 FAR 목표를 만족한다.
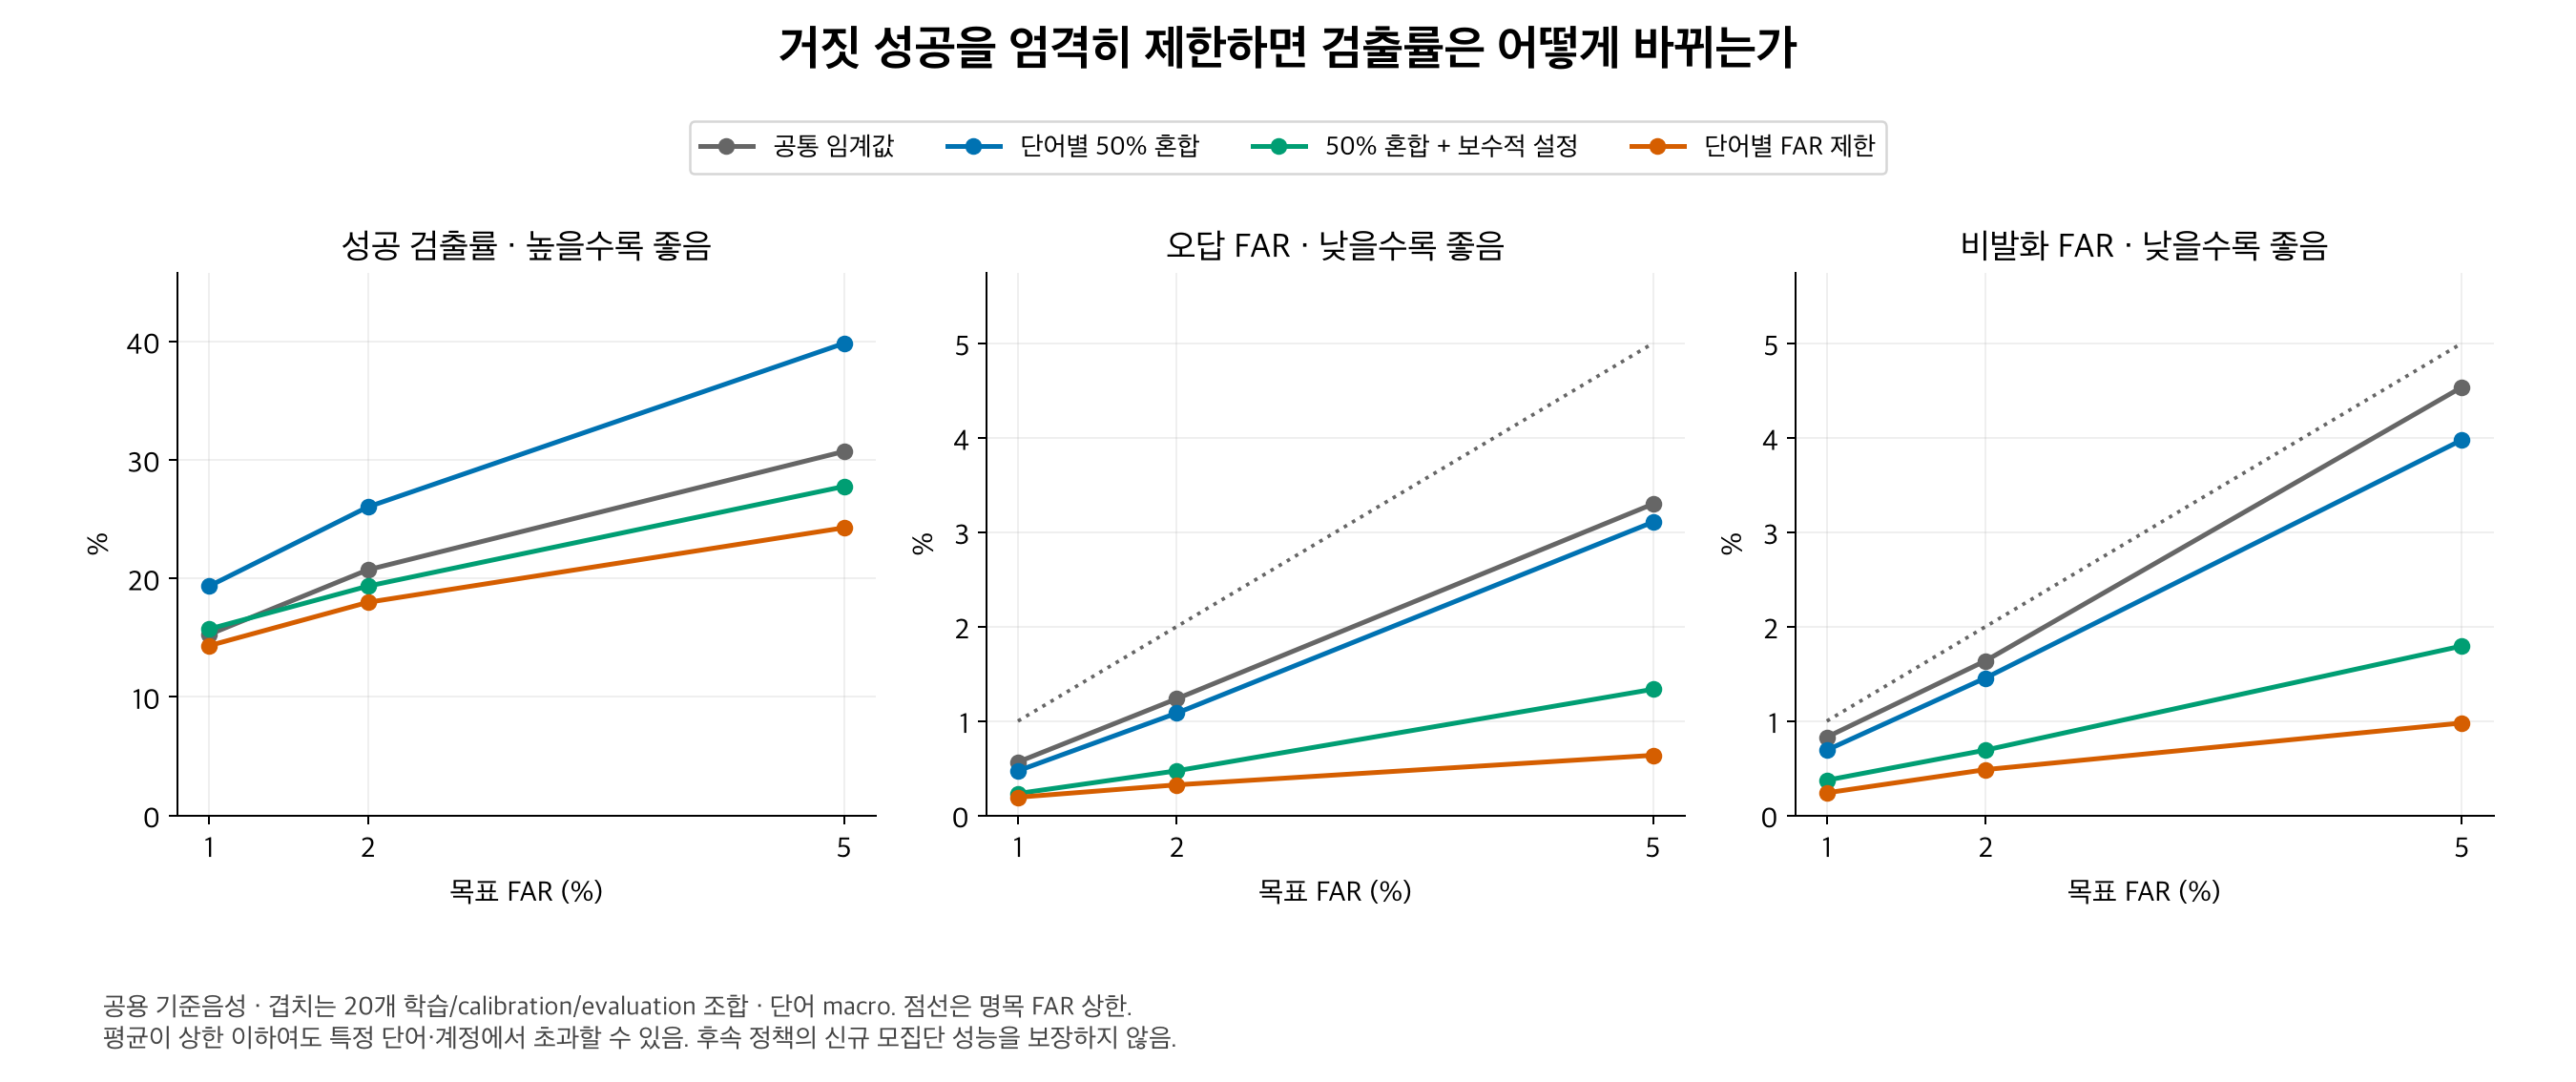 목표 FAR 1%, 2%, 5%별 검출률과 실제 FAR(20개 조합 기준). 파란색 단어별 50% 혼합이 같은 목표 FAR에서 가장 많이 검출한다. 주황색은 50% 혼합 뒤 단어마다 FAR 상한을 다시 맞춘 설정이다.
남은 문제: 안녕
공통 임계값에서는 안녕의 오답 FAR와 비발화 FAR가 각각 약 22%, 23%로, 잘못된 성공 판정이 이 한 단어에 집중된다. 단어별 임계값이 필요한 직접적인 근거다. 다만 단어마다 FAR 상한을 맞춘 설정(그림의 주황색)에서도 안녕의 FAR는 일부 평가 구간에서 6~10%로 남아, 추가 개선이 필요하다.
6-3. 추가 검증) 새 단어 일반화
서비스에서는 보호자가 새 단어를 등록하므로, 모델이 학습하지 않은 단어도 판정할 수 있어야 한다.
이를 확인하기 위해, 평가 단어를 학습에서 빼고 학습한 모델로 이 단어에 대한 평가를 진행했다. (학습 조건이 달라서 AUC를 6-1의 수치와 직접 비교할 수는 없다.)
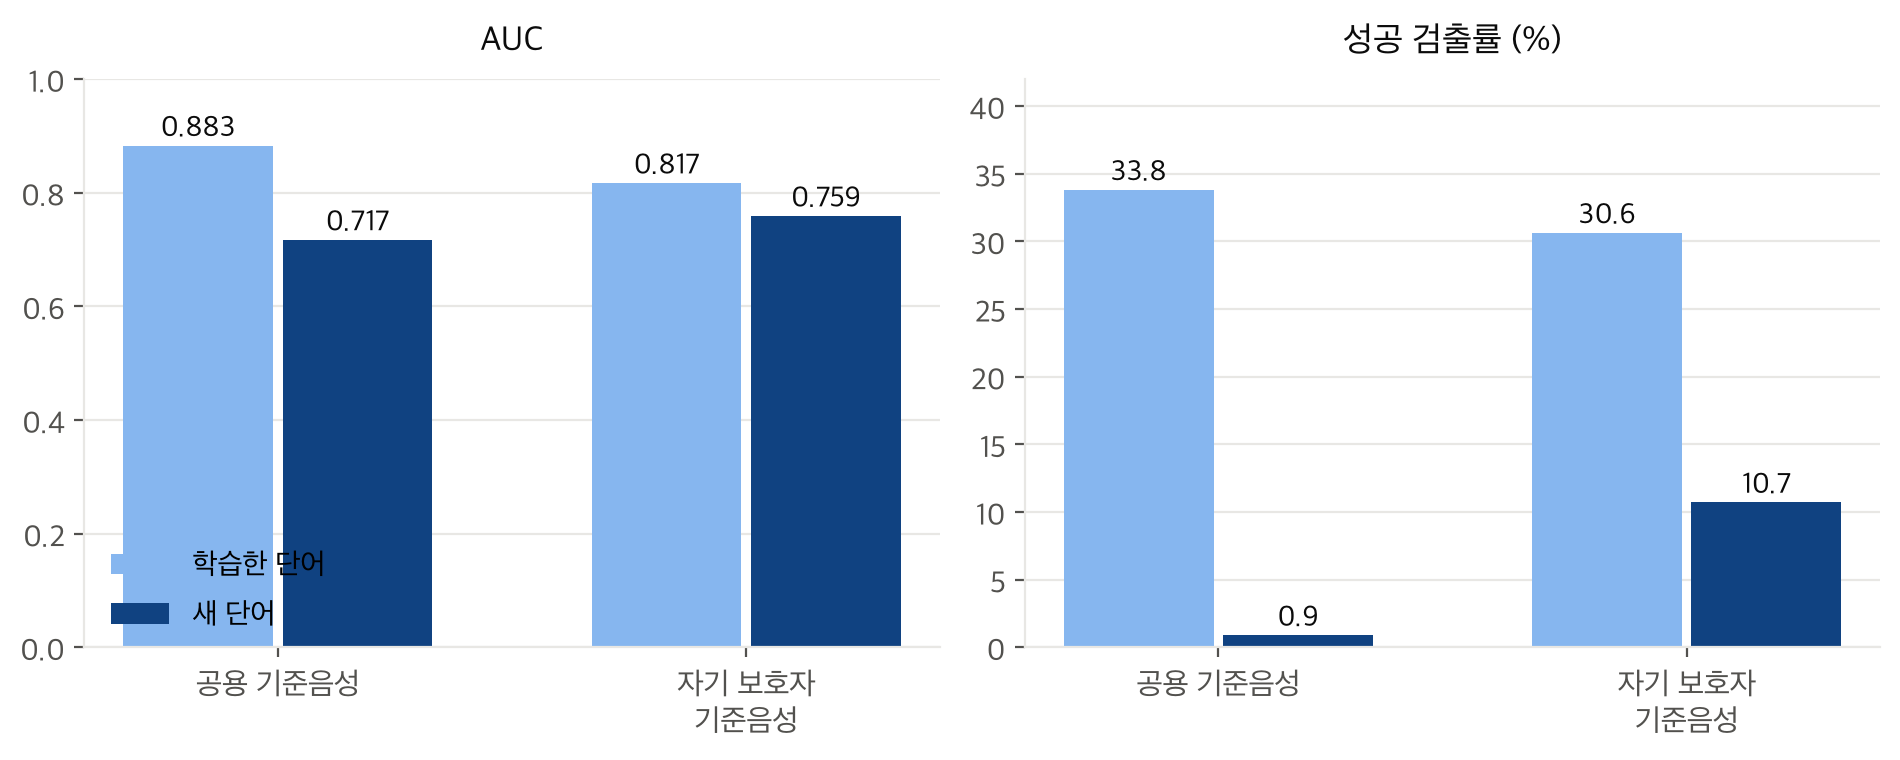 학습한 단어와 새 단어의 AUC, 성공 검출률 비교. 새 단어에서 검출률이 크게 하락한다.
| 기준음성 | AUC(학습한 단어 → 새 단어) | 성공 검출률(recall, 학습한 단어 → 새 단어) | 미지원 포함 검출률(새 단어) |
|---|---|---|---|
| 공용 | 0.883 → 0.717 | 33.82% → 0.89% | 0.89% |
| 자기 보호자(계정별) | 0.817 → 0.759 | 30.64% → 10.71% | 6.25% |
검출률은 학습한 단어에서 정한 임계값(목표 FAR 5%)을 새 단어에도 그대로 적용한 결과다.
현재 모델의 개선은 학습한 단어에 한정되고, 새 단어까지 일반화된다고 볼 수 없다.
7. 종합 결과
한눈에 보기
2026-09-28 라벨, 공용 기준음성, 목표 FAR 5%, 첫 번째 calibration 배정 기준이다.
| 지표 | 무학습 Perch | 순위 학습 + 공통 임계값 | 순위 학습 + 단어별 50% 혼합 | 읽는 법 |
|---|---|---|---|---|
| 단어 일치 AUC | 0.757 | 0.898 | 0.898 | 0.5가 무작위, 1.0이 완벽. 6-1 기준 |
| 성공 검출률 (판정 가능한 시도만) | 17.5% | 29.8% | 48.5% | 7개 단어 평균. 쪽, 코코야는 각 1건만 판정 가능 |
| 성공 검출률 (판정 불가 포함) | 17.5% | 29.8% | 41.3% | 판정할 수 없던 성공 시도도 실패로 셈 |
| 오답 FAR | 10.5% | 3.9% | 3.4% | 다른 단어를 성공으로 잘못 판정한 비율 |
| 비발화 FAR | 1.7% | 4.2% | 3.6% | 비발화를 성공으로 잘못 판정한 비율 |
새 단어에서는 공용 기준음성 조건의 AUC가 0.883 → 0.717로 떨어지고, 실제 성공 998건 중 1건만 검출했다.
인지해야 하는 부분
-
판정한 성공 시도의 대부분이 안녕이다. 998건 중 849건이다. 단어별 50% 혼합의 단어별 검출률은 안녕 60%, 까꿍 54%, 귀여워 52%, 안녕하세요 46%, 사랑해 28%다.
-
수치는 fold 배정에 민감하다. 기준음성 계정 분산 제약 없이 배정하면 AUC는 0.793, 판정 불가를 포함한 검출률은 25.7%다. 개발 데이터 안의 교차검증 수치이며, 새 계정에서 검증한 성능이 아니다.
결론
ContentVec은 화자 정보를 지우도록 학습된 인코더로, 사람과 앵무의 음색 차이를 줄여 높은 성능을 보인 것으로 추정된다.
다만 현재 성능으로는 서비스 판정에 바로 쓰기 어렵다. 무학습 Perch보다 검출률이 높고 오답 FAR는 낮지만, 판정 불가를 포함하면 실제 성공의 약 41%만 검출한다.