
0. 용어 정리
| 용어 | 의미 |
|---|---|
| VAD | Voice Activity Detection. 오디오에서 소리가 있는 구간만 잘라내는 처리 |
| 클립 | 판정 대상 오디오 한 개 |
| mimic (모사) | 앵무새가 사람 단어를 흉내 낸 클립 (안녕·사랑해·코코야 등) |
| non_speech (비발화) | 앵무새의 비발화 클립. 짹짹거림·경보음 같은 종 고유 발성 |
| reference (보호자 기준음성) | 보호자가 목표 단어를 직접 녹음한 사람 음성. 모사 성공의 비교 기준 |
| SSL | 자기지도학습(self-supervised) 음성 모델. 본문에서는 ContentVec·HuBERT를 가리킨다 |
| FAR (오통과율) | 비앵무(사람·잡음) 중 앵무로 잘못 통과한 비율 |
| AUC | 두 클래스를 구분하는 정도. 0.5는 무작위, 1.0은 완전 구분 |
1. buddybird는 서비스란?
버디버드는 앵무새에게 말을 가르쳐주는 앱 서비스이다. (https://buddybird.xyz/)
반려 앵무새는 보호자의 말을 흉내 낸다. buddybird는 학습용 단어 오디오를 들려주고, 앵무새가 낸 소리를 녹음·분석해
“오늘 우리 새가 ‘안녕’을 3번 따라 했어요” 같은 학습 리포트를 보내주는 서비스다.
이 서비스에서 핵심 기술은 ‘앵무새가 말을 따라 했는지’ 판정하여 리포트를 전송하는 것이다. 즉, 앵무새의 단어 모사 성공 여부 판정기술 개발이 필요하다.
기술적으로 까다로운 지점
- 공개된 앵무새 소리 데이터셋은 전무하다. 특히 단어 모사 데이터는 더 희귀하다.
- ‘사람 음성 인식’ 관련 기술은 많으나, 앵무새 음성에 대한 기술은 전무하다.
- 사람은 성대로 발화가 일어나지만, 앵무새는 명관을 통해 소리를 내므로, 포먼트/기준주파수 등 음향학적 특징에 차이가 있다. https://daeunworld.xyz/aisw_maestro/2026/09/03/parrot-human-acoustics.html
- 서비스 측면에서는,
- 마이크에는 앵무새 소리만 들어오지 않는다. 보호자·가족의 대화, 켜 둔 TV 소리, 생활 잡음이 함께 녹음된다. 이 소리들을 앵무새 소리로 착각하면 리포트 전체를 신뢰할 수 없게 된다.
- 사람 목소리가 실수로 앵무새 소리로 판단되어 저장되면, 개인정보처리 상의 문제가 될 수 있다.
이 글에서 다루는 내용은 이 판정 과정을 담당하는 오디오 파이프라인이다.
2. 전체 파이프라인
앱 서비스에서 수집된 오디오 클립은 아래 단계를 차례로 통과한다.
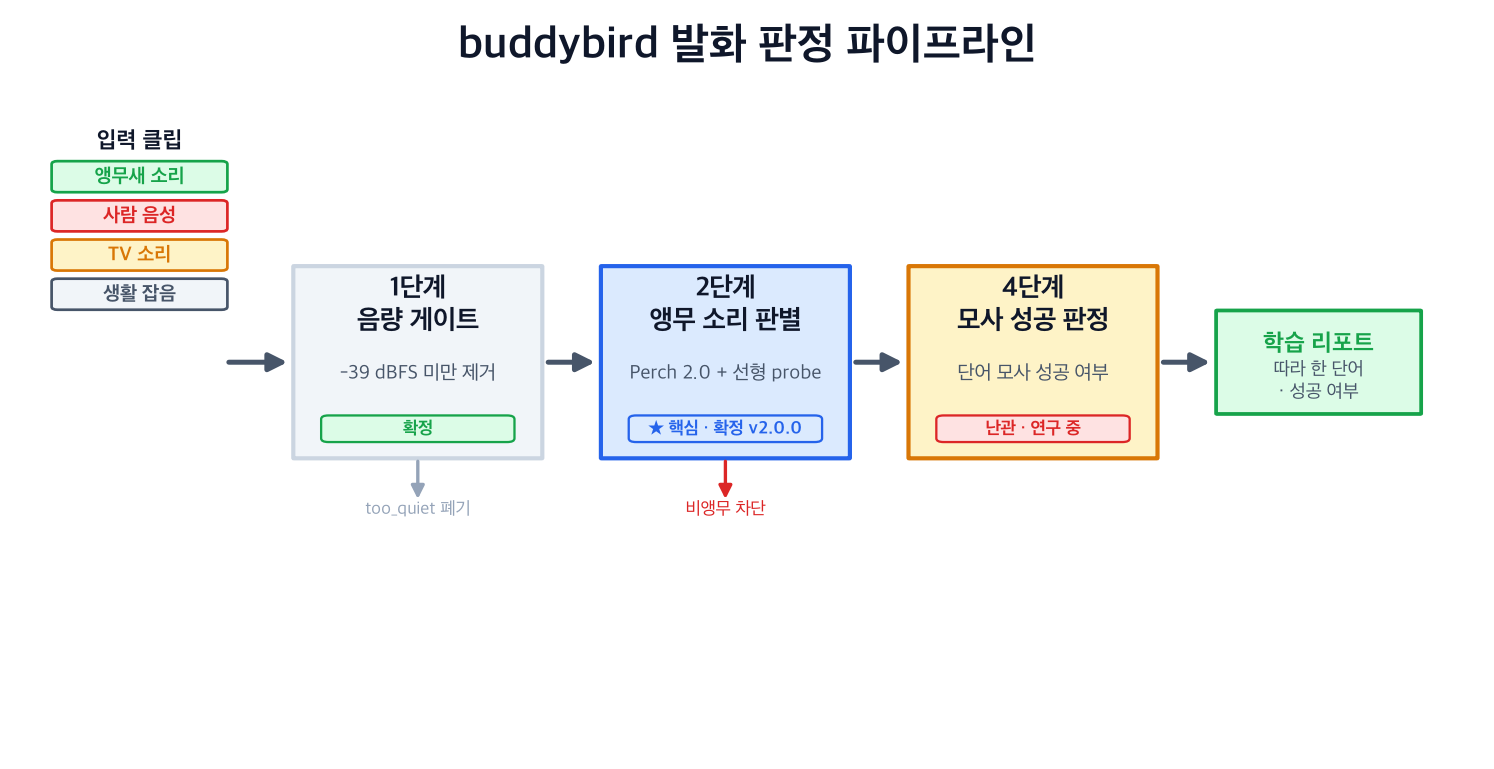
| 단계 | 하는 일 | 상태 |
|---|---|---|
| 0. VAD 입력 | station이 소리가 있는 구간만 잘라서 전달 | 프론트엔드(station) 책임 |
| 1. 음량 게이트 | 너무 조용해 판별이 무의미한 클립을 값싸게 버림 | ✅ 확정 |
| 2. 앵무 소리 판별 | 사람·TV·잡음을 걸러내는 핵심 관문 https://daeunworld.xyz/aisw_maestro/2026/09/12/parrot-sound-gate-v2-lr-development-evaluation.html | ✅ 확정 (v2.0.0) |
| 3. biodenoising | 앵무새 소리를 기준으로 다른 노이즈 제거 (성능 하락이 확인되어 기각된 단계) | — |
| 4. 모사 성공 판정 | 앵무새가 단어 모사에 성공했는지 판정 | ⚠️ 연구 중 |
- 캐스케이드(직렬) 구조라, 앞 단계의 실수가 뒤로 그대로 전파된다.
[1단계] 음량 게이트 loudness_gate (개발 완료)
무음에 가까운 클립을 차단하는 게이트이다.
- 규칙: 100ms 윈도우의 RMS 최댓값(
maxwin_db)이 -39 dBFS 미만이면too_quiet으로 차단한다. - 왜 100ms 윈도우인가: 앵무새의 단일 울음이 약 100ms다.
[2단계] — 앵무 소리 판별 게이트 parrot-sound-gate (개발 완료)
https://huggingface.co/buddybird-ai/parrot-sound-gate
https://daeunworld.xyz/aisw_maestro/2026/09/12/parrot-sound-gate-v2-lr-development-evaluation.html
클립이 앵무새 소리인지(is_parrot) 이진 판정한다.
채택 기술: Perch 2.0 임베딩 + 선형 probe
- Perch 2.0 Encoder: 구글이 공개한 생물음향(bioacoustics) 사전학습 모델의 인코더. 모델 자체는 생물종을 구분하는 것이 목적이다. Perch2.0 인코더는 오디오 클립을 1,536차원 임베딩 벡터로 바꾼다.
- 선형 probe: 임베딩 위에 얹은 가벼운 로지스틱 회귀(LR) 분류기. 소량 데이터에서도 과적합이 적고, 해석·재현이 쉽다.
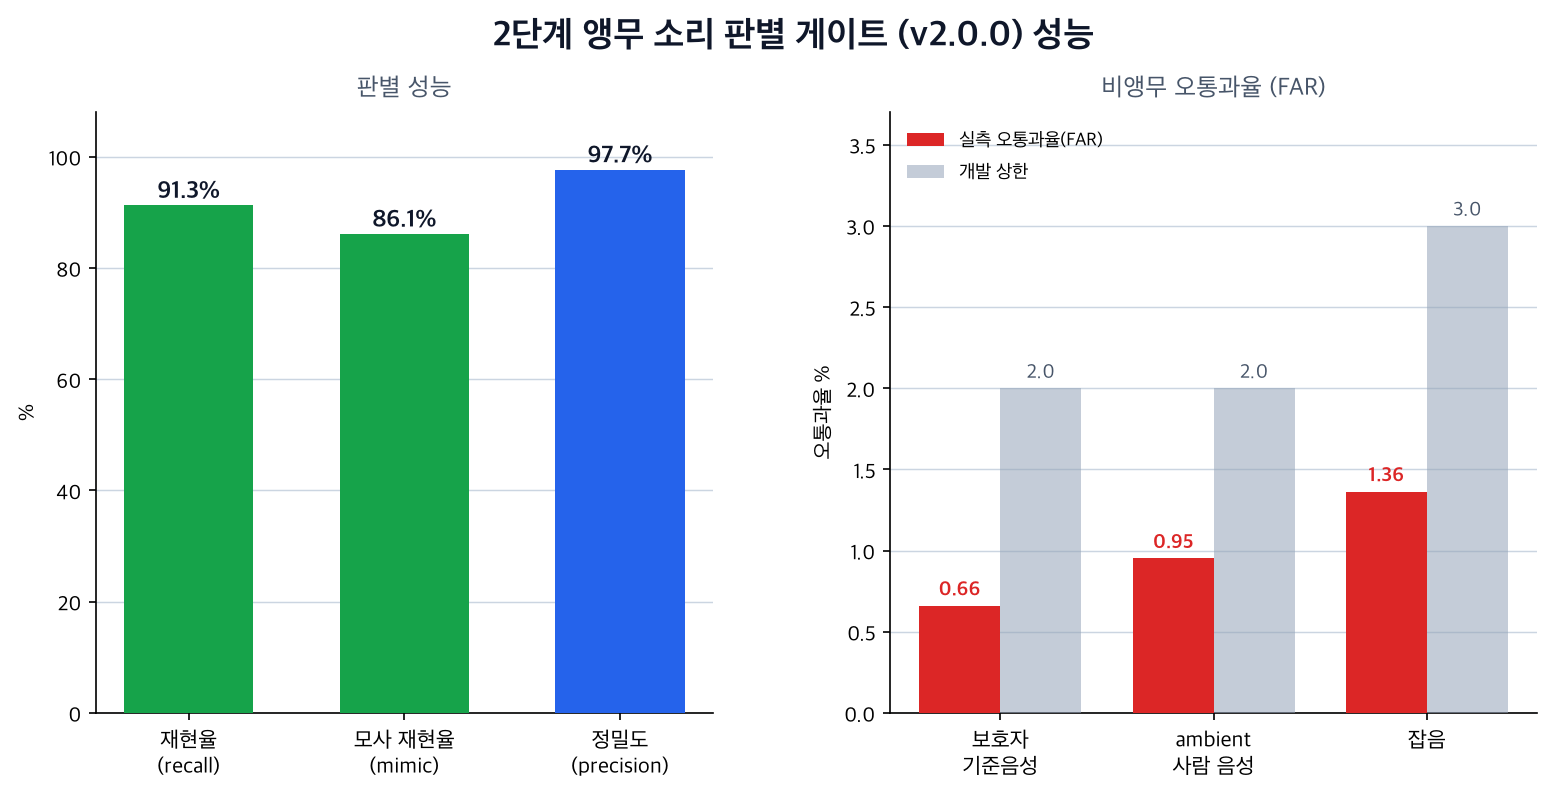
- 판별 성능: 재현율 91.3%, 모사(mimic) 재현율 86.1%, 정밀도 97.7%.
- 오통과율(FAR): 보호자 기준음성 0.66%, ambient 사람 음성 0.95%, 잡음 1.36%
[4단계] 앵무새가 단어 모사에 성공했는지 판정 (현재 개발중, 난관)
2단계를 통과한 앵무 소리가 학습 단어를 실제로 따라 했는지(모사 성공) 를 판정하는 단계다. 여기서부터 문제의 성격이 완전히 달라진다.
- 2단계는 “앵무냐 아니냐”의 이진 분류 문제였다.
- 4단계는 정답과의 유사도 측정에 가까운 문제다.
다양한 방법론을 시도했으나, 실제 서비스에 적용할 만한 성능을 낸 방안은 아직 없다.
난관
- 개인화된 단어: ‘세바스찬’처럼 지극히 개인적인 단어(반려동물 이름 등)의 모사까지 감지할 수 있어야 한다. 이런 단어는 다른 앵무새가 같은 단어를 발화한 데이터를 수집하는 것이 사실상 불가능하다.
- 도메인 갭: 판정을 위해
앵무새 소리 vs 사람 음성(보호자 기준음성)을 비교하면, 성대·명관 등 발성기관 차이에서 오는 도메인 갭이 존재할 수밖에 없다(아래 그림). - 기존 STT 사용 불가: 사람 음성 인식(Whisper STT 등) 기술로는 소·중형조 앵무새의 mimic을 인식하지 못한다. 사람 음성으로 학습된 모델에게 앵무 발성은 분포 밖(OOD) 입력이기 때문이다.
- mimic 데이터 희소: mimic 데이터 자체가 희귀하고, 다량 수집에 한계가 있다. 적격 단어는 9개뿐이며, 그중 ‘안녕’이 시도의 74%를 차지한다.
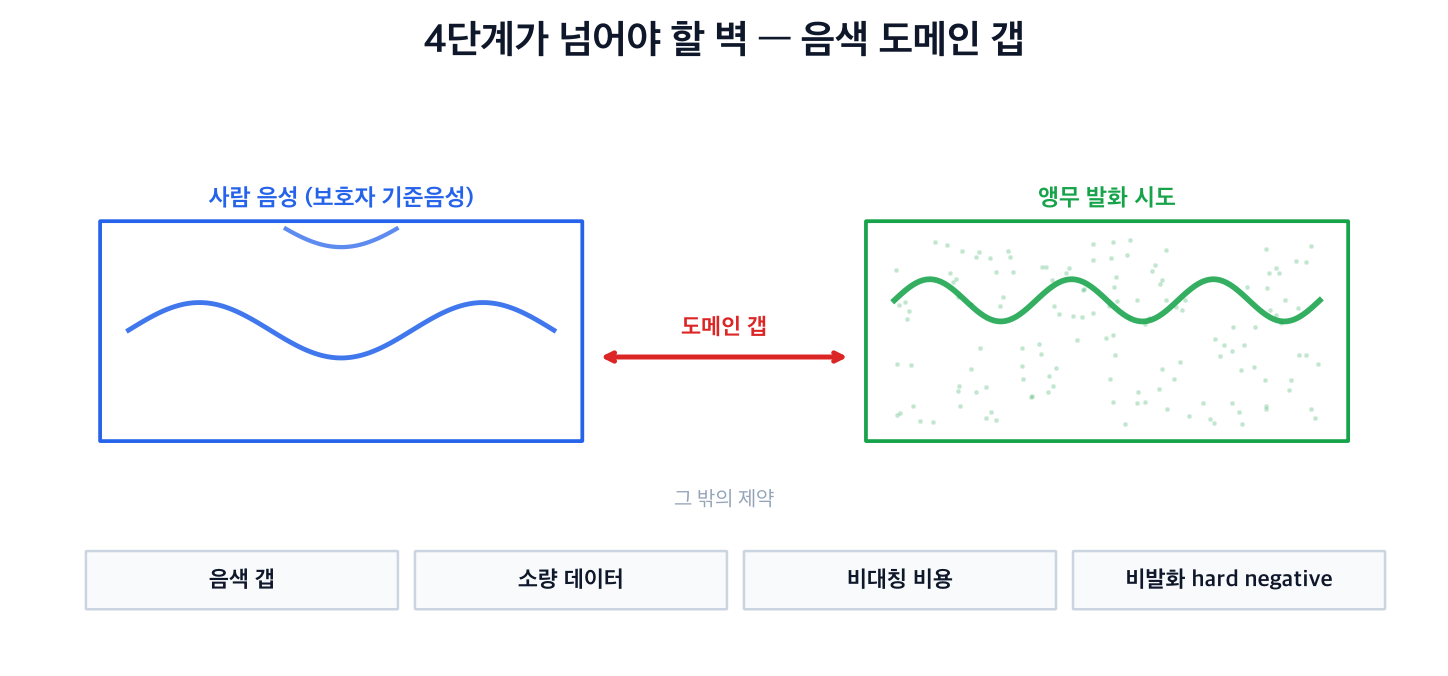
기준음성은 사람 목소리, 시도는 앵무 목소리다. 같은 단어라도 배음·포먼트 구조가 근본적으로 달라(음색 도메인 갭), 이 갭을 어떻게 넘느냐가 판정 방법 선택을 가른다.
지금까지 고려한 방안
(1)·(3)·(4)는 기준 음성 또는 exemplar과의 비교로 판정하는 방식이고, (2)는 비교 없이 앵무 소리만으로 직접 분류하는 방식이다.
(1) 보호자 기준음성(reference) vs 수집된 앵무 소리 [SSL 임베딩 + DTW]
[[추후 상세 보고서 링크 추가 예정]]
보호자 기준음성과 앵무 소리를 각각 SSL 임베딩(ContentVec·HuBERT)으로 표현하고, DTW로 시간
정렬해 유사도를 산출한다.
(2) 앵무 소리의 mimic / non_speech 분류 [로지스틱 회귀 선형 probe]
https://daeunworld.xyz/aisw_maestro/2026/09/24/mimic-nonspeech-encoders.html
기준음성과 비교하지 않고, 앵무 소리 임베딩만으로 ‘모사(mimic)’인지 ‘비발화(non_speech)’인지
직접 분류한다(단어 종류는 구분하지 않음).
Perch·ContentVec·HuBERT 임베딩을 입력으로 하는 회귀 선형 probe로 실험했다.
‘앵무새 모사 성공 여부 판정’ 대신, '앵무새가 특이한 소리를 냈어요!'의 알림을 보낼 수 있는 정도로 기술을 단순화했을 때의 방법론이다.
(3) 앵무새의 피치·포먼트로 변환한 보호자 기준음성 vs 수집된 앵무 소리
[[추후 상세 보고서 링크 추가 예정]]
도메인 갭을 표현이 아니라 입력 신호 단계에서 줄이는 접근이다.
보호자 기준음성(reference)
-> 앵무새의 피치·포먼트 특성으로 변환(voice conversion)
-> 수집된 앵무 소리와 비교하여 유사도 측정
(4) Cross-Species Metric Learning [frozen 임베딩 위 학습 head 사전학습 인코더]
[[추후 상세 보고서 링크 추가 예정]]
임베딩 인코더(Perch·ContentVec)는 그대로 고정(frozen)한 채, 그 임베딩 위에 작은 학습 가능한
층(triplet projection head)만 얹어 학습한다. 같은 단어는 가깝고 다른 단어·비발화는 멀어지도록
거리를 직접 배우게 하는 방식이다.
cross-species로 사람 기준음성과 앵무 시도를 같은 임베딩 공간에서 비교하려는 접근이다.